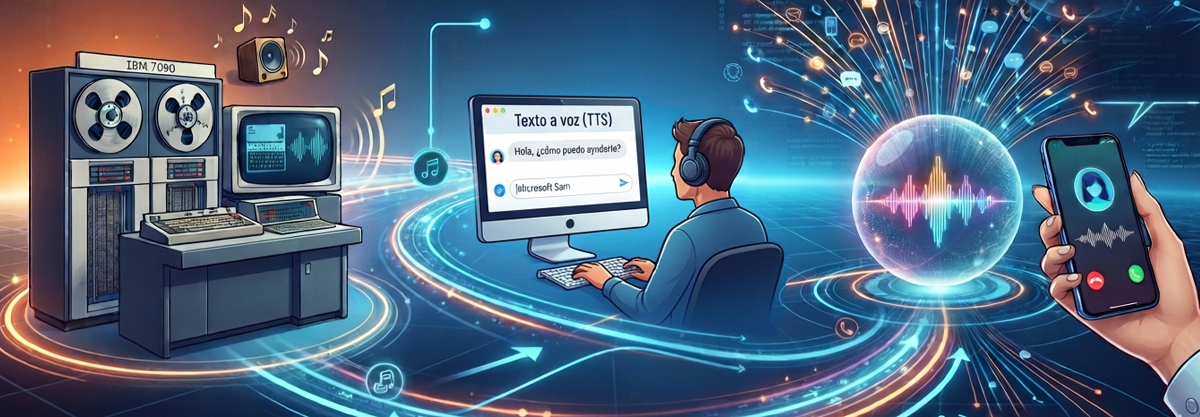
De la primera voz sintética a los agentes de IA: cómo evolucionaron la voz computacional, la telefonía y las conversaciones inteligentes.
En 1961, una computadora de Bell Labs interpretó “Daisy Bell” con una voz metálica y trabajosa. No entendía la canción, no podía responder una pregunta y mucho menos resolver una gestión. Pero aquella demostración dejó al público frente a una idea fascinante: las máquinas también podían tener voz.
Más de seis décadas después, un agente de inteligencia artificial puede atender una llamada, reconocer quién habla, comprender el motivo, consultar un sistema, reprogramar un turno, informar el estado de un pedido, registrar el resultado en un CRM y transferir la comunicación a una persona sin perder el contexto.
Entre ambas escenas, hubo una larga sucesión de avances que permitió que las máquinas aprendieran tres verbos: hablar, escuchar y actuar.
En una nota anterior sobre la historia de la síntesis de voz recorrimos la evolución de las primeras máquinas parlantes. Ahora ampliamos la mirada: ¿cuándo comenzó la computadora a comprendernos?, ¿cómo llegó la voz a millones de hogares y teléfonos?, ¿qué cambió con los agentes de IA? y, sobre todo, ¿qué escala alcanzó esta nueva industria?
La primera hazaña fue hablar
La voz electrónica nació antes que la computadora moderna. En la Feria Mundial de Nueva York de 1939, Bell Labs presentó el Voder, un dispositivo capaz de producir habla mediante tonos, ruido y filtros electrónicos. Sin embargo, no hablaba por sí mismo: una operadora entrenada debía accionar teclas y un pedal para construir cada sonido. Era más parecido a tocar un instrumento que a conversar con una máquina.
En 1961 llegó “Daisy Bell”, una computadora generó la voz y demostró que la síntesis podía convertirse en software. Todavía no era un sistema de texto a voz capaz de leer libremente cualquier contenido, pero marcó un cambio decisivo: la producción de habla ya no dependía exclusivamente de componentes mecánicos o de grabaciones previamente almacenadas.
Durante las décadas siguientes aparecieron sistemas como DECtalk, Speak & Spell y las primeras tecnologías de accesibilidad. Las voces sonaban robóticas, pero ya cumplían funciones concretas: leer textos, ayudar a personas ciegas, informar horarios o reproducir mensajes telefónicos.
La naturalidad vendría mucho después. Primero había que lograr que la voz fuera comprensible.
Escuchar resultó mucho más difícil
Hacer que una máquina produjera sonidos era un problema complejo. Conseguir que entendiera una voz humana era todavía más difícil.
En 1952, Audrey, desarrollado por Bell Labs, reconocía los dígitos pronunciados por una persona previamente calibrada. IBM Shoebox amplió luego esa capacidad a diez números y algunos comandos aritméticos. Pero esos sistemas no comprendían el lenguaje, solo clasificaban un conjunto muy pequeño de patrones acústicos bajo condiciones controladas.
El avance fue gradual:
- primero reconocieron dígitos
- después, palabras aisladas
- más tarde, vocabularios de cientos o miles de términos
- finalmente, habla continua producida por diferentes personas
Durante los años setenta y ochenta, proyectos como Harpy, Tangora y Sphinx incorporaron modelos probabilísticos para determinar qué secuencia de palabras era más probable. Tangora llegó a trabajar con unas 20.000 palabras, mientras Sphinx avanzó hacia el reconocimiento continuo e independiente del hablante.
Ese último punto fue fundamental. Ningún sistema podía volverse masivo si obligaba a cada usuario a entrenarlo durante horas.
A fines de los noventa, productos como Dragon NaturallySpeaking llevaron el dictado continuo a las computadoras personales. Ya era posible hablar y observar cómo las palabras aparecían en pantalla, aunque el ruido, los acentos, los nombres propios y los micrófonos deficientes todavía generaban numerosos errores.
El teléfono se convirtió en un gran laboratorio
Mientras las computadoras personales aprendían a transcribir, la telefonía desarrollaba su propia evolución.
Los primeros sistemas automáticos utilizaron tonos DTMF y mensajes grabados. Así nacieron los conocidos menús de “para ventas, marque 1; para administración, marque 2”. El IVR resolvió un problema de escala: permitía ordenar miles de llamadas sin intervención humana. Pero lo hacía obligando al cliente a recorrer la estructura interna de la empresa.
La persona debía aprender el menú. El sistema no aprendía a la persona.
Con el tiempo, algunos IVR incorporaron reconocimiento de palabras y gramáticas cerradas. Podían entender “ventas”, “soporte” o “saldo”, pero cualquier respuesta fuera de lo esperado quedaba fuera del recorrido.
Uno de los antecedentes más interesantes fue MIT Jupiter, un sistema disponible públicamente por teléfono desde 1997 que respondía consultas meteorológicas. Durante sus primeros años recibió más de 30.000 llamadas y procesó alrededor de 180.000 expresiones habladas.
Jupiter ya combinaba reconocimiento, comprensión, diálogo y síntesis de voz. No podía conversar libremente sobre cualquier tema, pero mostraba que una computadora podía atender una llamada y conducir un diálogo orientado a una tarea.
La llegada de VoiceXML en los años 2000 facilitó el desarrollo de aplicaciones telefónicas con mensajes, reconocimiento, tonos, interrupciones y reglas de navegación. Fue una pieza decisiva para la expansión del autoservicio telefónico. El problema era que la conversación seguía estando escrita de antemano.
Siri, Alexa y el momento en que la voz se volvió masiva
El siguiente salto no llegó solamente por una mejora en la precisión. Llegó por la distribución.
Los teléfonos inteligentes incorporaron micrófonos, conexión permanente, cuentas de usuario, servicios en la nube y acceso a información personal. La voz dejó de vivir en un laboratorio o en una central telefónica y pasó a acompañar a millones de personas durante todo el día.
Siri, incorporada al iPhone 4S en 2011, convirtió al smartphone en la principal plataforma de distribución de asistentes de voz. Alexa llevó la interacción al hogar en 2014. Cortana se integró a Windows y Google Assistant apareció en 2016 como una experiencia conversacional conectada con búsquedas, aplicaciones y dispositivos.
La escala creció rápidamente, aunque cada empresa comenzó a medirla de una manera diferente.
- Apple informó alrededor de 2.000 millones de solicitudes semanales a Siri en 2016. En 2024 comunicó aproximadamente 1.500 millones de solicitudes de voz por día.
- Amazon habló de miles de millones de interacciones semanales con Alexa en 2020 y de decenas de millones por hora en 2023.
- Google, en cambio, informó más de 500 millones de usuarios mensuales de Assistant en 2020 y más de 700 millones en 2022.
Las cifras muestran un fenómeno masivo, pero no son directamente comparables. Una empresa publica solicitudes, otra interacciones, otra usuarios activos y otra dispositivos vendidos. Contar voces resultó más sencillo que contar qué estaba ocurriendo realmente dentro de cada conversación.
El salto neuronal: cuando la voz dejó de sonar inevitablemente robótica
Durante muchos años, la síntesis se construyó ensamblando sonidos o aplicando reglas sobre fonemas y formantes. El resultado podía entenderse, pero conservaba una cadencia artificial.
En 2016, WaveNet mostró que una red neuronal podía generar directamente la forma de onda del audio. Tacotron y otros modelos posteriores mejoraron la pronunciación, el ritmo, las pausas y la entonación. La voz sintética comenzó a dejar de ser un simple altavoz de texto y pasó a convertirse en una interpretación.
El reconocimiento también cambió. Whisper, publicado en 2022 y entrenado con 680.000 horas de audio, amplió la capacidad de transcribir distintos idiomas, acentos y entornos.
En 2024, GPT-4o incorporó procesamiento nativo de audio. OpenAI informó respuestas con un mínimo de 232 milisegundos y un promedio de 320 milisegundos, acercando la latencia a la dinámica de una conversación humana.
La tubería tradicional (escuchar, convertir a texto, procesar, volver a generar texto y sintetizar la respuesta) comenzó a convivir con modelos capaces de trabajar con audio de extremo a extremo. Pero la voz natural, por sí sola, no explica la transformación actual.
Del asistente al agente: la voz empezó a actuar
Siri, Alexa y Google Assistant popularizaron la idea de pedir algo mediante la voz. Sin embargo, gran parte de esas interacciones eran breves: consultar el clima, reproducir música, crear un recordatorio o encender una luz.
La nueva generación de agentes incorpora una diferencia fundamental: puede utilizar herramientas y actuar sobre sistemas.
Un agente de voz moderno puede:
- Identificar a un cliente
- Consultar un CRM o una base de datos
- Informar el estado de una compra
- Agendar o reprogramar un turno
- Realizar una validación
- Iniciar una cobranza
- Registrar el resultado de la conversación
- Enviar una confirmación
- Transferir la llamada a una persona con todo el contexto
La evolución no consiste simplemente en reemplazar una voz robótica por otra más agradable. Cambia la lógica completa de la interacción.
El viejo IVR decía: “Elegí una opción de mi menú”.
El agente moderno pregunta: “¿Qué necesitás resolver?”.
A partir de 2023 coincidieron cinco tecnologías que ya habían alcanzado suficiente madurez: telefonía programable, reconocimiento en tiempo real, síntesis neuronal, modelos de lenguaje capaces de mantener contexto y plataformas de orquestación que administran turnos, herramientas, transferencias y registros.
Así surgió una nueva cohorte de empresas:
- Vapi y Retell priorizan la orquestación configurable
- Bland y Replicant desarrollan soluciones de llamadas de extremo a extremo
- Synthflow facilita la construcción no-code
- PolyAI, Cognigy y Parloa trabajan implementaciones empresariales
- ElevenLabs, Deepgram y Hume avanzaron desde los modelos de voz hacia agentes completos
Por esto, no podemos decir que existe un único “sistema de voz”. Detrás de una conversación pueden participar varias empresas al mismo tiempo.
La escala dejó de ser experimental
Los anuncios publicados por las plataformas durante 2025 y 2026 permiten dimensionar el cambio.
Vapi informó más de 1.000 millones de llamadas acumuladas, mientras su CEO ubicó el flujo corriente entre uno y cinco millones de llamadas diarias.
Retell AI comunicó más de 55 millones de llamadas mensuales.
Bland AI reportó más de 3,5 millones por semana.
Replicant superó los 1.000 millones de minutos telefónicos automatizados acumulados.
Para llevar esos anuncios a una unidad común, el informe elaborado por Llamada IP construyó escenarios de minutos bajo, central y alto.
En el escenario central anualizado para 2026, los órdenes de magnitud son:
- Vapi: cerca de 4.930 millones de minutos.
- Retell AI: aproximadamente 2.970 millones.
- Bland AI: alrededor de 821 millones.
- Replicant: unos 270 millones.
- Synthflow AI: aproximadamente 260 millones.
Estas cifras no son tráfico auditado ni cuotas de mercado. Son estimaciones construidas a partir de llamadas publicadas, acumulados, ritmos diarios o mensuales y supuestos de duración. Deben leerse como una brújula, no como una tabla definitiva de posiciones.
No todos los minutos significan lo mismo
Una consulta a Siri puede durar cinco u ocho segundos. Una llamada de soporte, ventas o cobranzas puede extenderse durante varios minutos. Por eso, que una plataforma procese más minutos no significa automáticamente que tenga más clientes, mayores ingresos o una tecnología superior.
Tampoco pueden sumarse indiscriminadamente los minutos de cada capa. Una llamada administrada por Vapi podría utilizar reconocimiento de Deepgram, una voz de ElevenLabs y transporte telefónico de Twilio o de un operador local. Si se sumara el tráfico de todos ellos, la misma conversación aparecería contada varias veces.
La comparación más honesta separa:
- asistentes de consumo
- agentes telefónicos completos
- plataformas de orquestación
- motores de reconocimiento
- sistemas de síntesis
- operadores y proveedores de telefonía
Esta diferencia metodológica puede parecer un detalle, pero es esencial para entender una industria que todavía publica métricas fragmentadas y comerciales.
El teléfono no desapareció: se volvió programable
Durante años se anunció que las aplicaciones y la mensajería harían desaparecer la llamada telefónica. Sin embargo, ocurrió algo más interesante: el teléfono dejó de ser solamente un canal entre dos personas y comenzó a transformarse en una interfaz capaz de accionar sistemas.
El número sigue siendo la puerta de entrada. La red sigue transportando la conversación. Pero detrás de esa llamada ahora puede existir una inteligencia capaz de interpretar, decidir y ejecutar.
Para que funcione en el mundo real siguen siendo necesarios:
- Numeración local, nacional e internacional
- Números geográficos, 0800 y 0810
- Portabilidad numérica
- Troncales SIP
- Interconexión con operadores
- Transporte de audio con baja latencia
- Identificación correcta de las llamadas
- Capacidad para atender comunicaciones simultáneas
- Transferencias hacia personas o sectores
- Monitoreo, grabación y trazabilidad
Como analizamos en nuestra nota sobre la diferencia entre una demo de IA y un servicio de telefonía real, una voz extraordinaria no puede compensar una llamada que no conecta, un audio entrecortado o una transferencia fallida.
La inteligencia puede decidir qué hacer. La infraestructura telefónica debe lograr que efectivamente ocurra.
La próxima competencia no será solamente por sonar más humano
La naturalidad de la voz seguirá mejorando. También disminuirán la latencia y los costos.
Pero la verdadera competencia se desplazará hacia otros indicadores como cuántas gestiones logra resolver el agente, con qué frecuencia se equivoca, cuánto tarda en responder, cuándo y cómo deriva a una persona, qué contexto conserva durante la transferencia, cuánto cuesta cada resultado alcanzado, cómo protege los datos o qué evidencia ofrece sobre cumplimiento y calidad.
El objetivo no debería ser construir una máquina que finja ser humana. Debería ser crear una experiencia clara, útil y responsable, capaz de resolver tareas repetitivas y dejar a las personas aquellas situaciones donde el criterio, la negociación o la empatía resultan irremplazables.
En Llamada IP trabajamos precisamente en la capa que conecta esta nueva inteligencia con la telefonía real: numeración, portabilidad, llamadas entrantes y salientes, SIP trunking, rutas, integración con plataformas de agentes y presencia en distintos países. Después de casi un siglo aprendiendo a hablar y escuchar, las máquinas comenzaron a actuar.
Y el viejo teléfono, lejos de desaparecer, se convirtió en una de las interfaces más simples y poderosas para conectarnos con esa nueva inteligencia.
¿Querés explorar cómo incorporar un agente de voz manteniendo el número y la infraestructura de tu empresa? Conversá con el equipo de Llamada IP escribiendo a ventas@llamadaip.com y diseñemos una implementación preparada para operar en el mundo real.
Notas relacionadas
Historia de la síntesis de voz por computadora: de máquinas mecánicas a la IA conversacional
Cómo funcionan los agentes de voz con IA: la tecnología detrás de cada llamada inteligente
La IA de voz puede parecer fácil. Hacer que funcione como telefonía real no lo es.